Skip to content

第一章 基本概念 ​

1.总体: ​

研究对象的全体。通常指研究对象的某项数量指标。组成总体的元素称为个体。 从本质上讲,总体就是所研究的随机变量或随机变量的分布。

2.样本: ​

来自总体的部分个体X1,…,Xn\mathbf{X}_1, \dots, \mathbf{X}_n 如果满足: (1)同分布性: Xi\mathbf{Xi},i=1,…,n$\text{与总体同分布}.(2)独立性:. (2)独立性:\mathbf{X}_1, \dots, \mathbf{X}_n$ 相互独立\text{相互独立};则称为容量为n 的简单随机样本,简称样本。而称X1,…,Xn\mathbf{X}_1, \dots, \mathbf{X}_n 的一次实现为样本观察值,记为x1,…,xn\mathbf{x}_1, \dots, \mathbf{x}_n 来自 总体X 的 随机样本 X1,⋯ ,Xn\mathbf{X}_1, \cdots, \mathbf{X}_n 可记为

X1,⋯ ,Xn∼iidX或f(x),F(x),…X_1, \cdots, X_n \overset{iid}{\sim} X \quad \text{或} \quad f(x), F(x), \dots

显然,样本联合分布函数或密度函数为

F∗(x1,x2,⋯ ,xn)=∏i=1nF(xi)F^*(x_1, x_2, \cdots, x_n) = \prod_{i=1}^{n} F(x_i)

或

f∗(x1,x2,⋯ ,xn)=∏i=1nf(xi)f^*(x_1, x_2, \cdots, x_n) = \prod_{i=1}^{n} f(x_i)

3.统计量 ​

称样本 X1,⋯ ,XnX_1, \cdots, X_n 的函数 g(X1,⋯ ,Xn)g(X_1, \cdots, X_n) 是总体 XX 的一个 统计量\text{统计量}, 如果 g(X1,⋯ ,Xn)g(X_1, \cdots, X_n) 不含未知参数\text{不含未知参数}。

几个常用的统计量:

  1. 样本均值 (Sample Mean)

Xˉ=1n∑i=1nXi\bar{X} = \frac{1}{n} \sum_{i=1}^{n} X_i

  1. 样本方差 (Sample Variance)

S2=1n−1∑i=1n(Xi−Xˉ)2S^2 = \frac{1}{n-1} \sum_{i=1}^{n} (X_i - \bar{X})^2

(注意:这里的系数是 1n−1\frac{1}{n-1} 而不是 1n\frac{1}{n},这是为了保证它是无偏估计量)

样本均方差(标准差) (Sample Standard Deviation)

S=S2S = \sqrt{S^2}

3. 样本k阶矩

  • 样本原点矩 (Sample Moment about Origin)

1n∑i=1nXik\frac{1}{n} \sum_{i=1}^{n} X_i^k

(注:当 $k=1$ 时,这就是样本均值)
  • 样本中心矩 (Sample Central Moment)

1n∑i=1n(Xi−Xˉ)k\frac{1}{n} \sum_{i=1}^{n} (X_i - \bar{X})^k

(注:当 $k=2$ 时,这对应于样本方差的某种形式,但通常样本方差分母为 $n-1$)

4. 经验分布函数 (Empirical Distribution Function)

用 S(x)S(x) 表示样本 X1,⋯ ,XnX_1, \cdots, X_n 中不大于 xx 的随机变量个数。定义经验分布函数 Fn(x)F_n(x) 为:

Fn(x)=1nS(x)F_n(x) = \frac{1}{n} S(x)

4.常用统计量的分布(抽样分布): ​
**一、χ2\chi^2 分布 ** ​
1. 构造 ​

设 X1,⋯ ,XnX_1, \cdots, X_n 独立同分布于标准正态分布,即 X1,⋯ ,Xn∼iidN(0,1)X_1, \cdots, X_n \overset{iid}{\sim} N(0,1)。

则定义统计量:

χ2=∑i=1nXi2∼χ2(n)\chi^2 = \sum_{i=1}^{n} X_i^2 \sim \chi^2(n)

称为自由度为 nn 的 χ2\chi^2 分布。

笔记要点:χ2\chi^2 分布本质上就是 nn 个独立的标准正态随机变量的平方和。

2. χ2\chi^2 分布的概率密度函数 ​
概率密度函数 公式为:

f(y)={12n/2Γ(n/2)yn2−1e−y2,y>00,y≤0f(y) = \begin{cases} \frac{1}{2^{n/2}\Gamma(n/2)} y^{\frac{n}{2}-1} e^{-\frac{y}{2}}, & y > 0 \\ 0, & y \le 0 \end{cases}

  • 其中 Γ(⋅)\Gamma(\cdot) 是伽马函数。

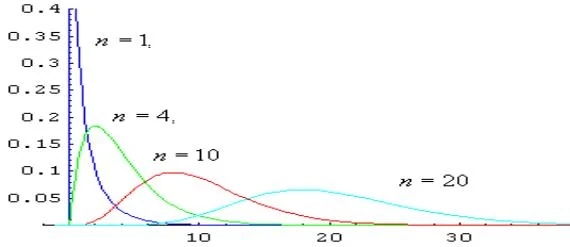
  • Pasted image 20251122110855
    • 特点:分布是非对称的(右偏),取值恒为正。随着自由度 nn 的增大,曲线峰值向右移动,且图形逐渐趋向于对称(正态分布)。
3. χ2\chi^2 分布的分位点 ​

设 X∼χ2(n)X \sim \chi^2(n),若对于 α:0<α<1\alpha: 0 < \alpha < 1,存在 χα2(n)>0\chi^2_{\alpha}(n) > 0 满足:

P{X≥χα2(n)}=αP\{X \ge \chi^2_{\alpha}(n)\} = \alpha

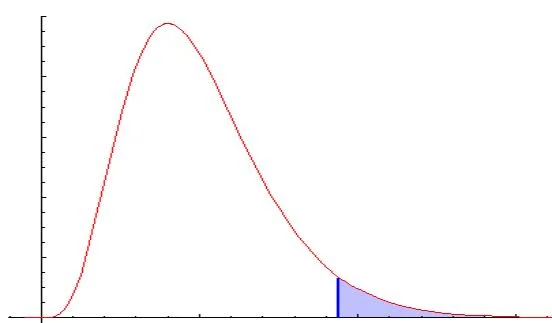
则称 χα2(n)\chi^2_{\alpha}(n) 为 χ2(n)\chi^2(n) 分布的 上 α\alpha 分位点 (Upper α\alpha quantile)。 Pasted image 20251122111115

图示说明:

  • 图中阴影部分的面积为 α\alpha(右尾概率)。
  • χα2(n)\chi^2_{\alpha}(n) 是横轴上的临界值。

举例 :

  • χ0.052(10)=18.307\chi^2_{0.05}(10) = 18.307 (表示自由度为10时,大于18.307的概率是0.05)
  • χ0.952(10)=3.940\chi^2_{0.95}(10) = 3.940 (表示自由度为10时,大于3.940的概率是0.95)
4.χ2\chi^2 分布的性质 ​
  • a. 分布可加性 (Additivity)

    若 X∼χ2(n1)X \sim \chi^2(n_1), Y∼χ2(n2)Y \sim \chi^2(n_2),且 X,YX, Y 相互独立,

    则它们的和服从自由度相加的 χ2\chi^2 分布:

X+Y∼χ2(n1+n2)X + Y \sim \chi^2(n_1 + n_2)

  • b. 期望与方差 (Expectation and Variance)

    若 X∼χ2(n)X \sim \chi^2(n),则:

    • 期望:E(X)=nE(X) = n
    • 方差:D(X)=2nD(X) = 2n (记忆技巧:期望等于自由度,方差等于两倍自由度)
二、 tt 分布 ​
1. 构造 (Construction) ​

这是 tt 分布最经典的定义方式,一定要背下来:

  • 设 ξ∼N(0,1)\xi \sim N(0, 1) (ξ\xi 是标准正态分布)

  • 设 η∼χ2(n)\eta \sim \chi^2(n) (η\eta 是自由度为 nn 的卡方分布)

  • 且 ξ\xi 与 η\eta 相互独立

则构造出的统计量 TT 为:

T=ξη/n∼t(n)T = \frac{\xi}{\sqrt{\eta / n}} \sim t(n)

称 t(n)t(n) 为 自由度为 nn 的 tt 分布。 注:t分布的直观理解:

  • 分子是一个标准正态变量。

  • 分母是一个调整后的卡方变量的平方根(起到了“归一化”或“缩放”的作用)。

  • 当样本量 n→∞n \to \infty 时,tt 分布会收敛于标准正态分布 N(0,1)N(0,1)。但在小样本下,tt 分布的尾部比正态分布更“厚”(更平坦),这使得它在小样本估计中更为保守和准确。

2.**t(n)t(n) 的概率密度 ​

f(t)=Γ(n+12)nπΓ(n2)(1+t2n)−n+12,−∞<t<∞f(t) = \frac{\Gamma(\frac{n+1}{2})}{\sqrt{n\pi}\Gamma(\frac{n}{2})} \left(1+\frac{t^2}{n}\right)^{-\frac{n+1}{2}}, \quad -\infty < t < \infty

  • 公式组成:

    • Γ(⋅)\Gamma(\cdot):这是 **数学分析#伽马函数 (Gamma Function, 欧拉第二积分),它是阶乘在实数域上的推广。

    • (1+t2n)−n+12\left(1+\frac{t^2}{n}\right)^{-\frac{n+1}{2}}:这是函数的主体部分,是一个幂函数形式,它决定了 tt 分布呈钟形曲线,且比正态分布下降得更慢(即“厚尾”)。

3.基本性质 ​
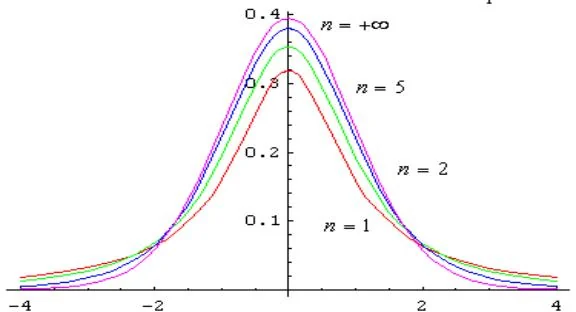
Pasted image 20251122112528 1. **对称性**: $f(t)$ 关于 $t=0$(纵轴)对称。
  1. 极限性质: 当自由度 n→∞n \to \infty 时,f(t)f(t) 的极限是标准正态分布 N(0,1)N(0, 1) 的密度函数,即:

lim⁡n→∞f(t)=φ(t)=12πe−t22,−∞<x<∞\lim_{n \to \infty} f(t) = \varphi(t) = \frac{1}{\sqrt{2\pi}} e^{-\frac{t^2}{2}}, \quad -\infty < x < \infty

3. 分位点 ​

设 T∼t(n)T \sim t(n),若对于 α:0<α<1\alpha: 0 < \alpha < 1,存在 tα(n)t_\alpha(n),满足:

P{T≥tα(n)}=αP\{T \ge t_\alpha(n)\} = \alpha

则称 tα(n)t_\alpha(n) 为 t(n)t(n) 的上侧 α\alpha 分位点。

重点性质:分位点的对称性 ​

由于 tt 分布关于 t=0t=0 对称,因此:

t1−α(n)=−tα(n)t_{1-\alpha}(n) = -t_{\alpha}(n)

示例:

  • t0.01(20)=2.5280t_{0.01}(20) = 2.5280

  • t0.99(20)=t1−0.01(20)=−t0.01(20)=−2.5280t_{0.99}(20) = t_{1-0.01}(20) = -t_{0.01}(20) = -2.5280

三、F\mathbf{F}分布 ​
1.构造 ​
  • 定义: F分布是通过两个独立的卡方(χ2\chi^2)随机变量的比值构造而成的。

  • 构造公式: 设 η1\eta_1 和 η2\eta_2 是两个独立的卡方随机变量,其自由度分别为 n1n_1 和 n2n_2:

    • η1∼χ2(n1)\eta_1 \sim \chi^2(n_1)

    • η2∼χ2(n2)\eta_2 \sim \chi^2(n_2)

      则随机变量 FF 的构造如下:

F=η1/n1η2/n2∼F(n1,n2)F = \frac{\eta_1/n_1}{\eta_2/n_2} \sim F(n_1, n_2)

  • 自由度: n1n_1 称为第一自由度(分子自由度),n2n_2 称为第二自由度(分母自由度)。
2. 概率密度函数 ​

对于 F(n1,n2)F(n_1, n_2) 分布,其概率密度函数 h(y)h(y) 如下(其中 Γ\Gamma 是伽马函数):

h(y)={Γ(n1+n22)(n1/n2)n1/2Γ(n12)Γ(n22)yn12−1(1+n1n2y)(n1+n2)/2,y>00,y≤0h(y) = \begin{cases} \frac{\Gamma\left(\frac{n_1+n_2}{2}\right) \left(n_1/n_2\right)^{n_1/2}}{\Gamma\left(\frac{n_1}{2}\right) \Gamma\left(\frac{n_2}{2}\right)} \frac{y^{\frac{n_1}{2}-1}}{\left(1+\frac{n_1}{n_2}y\right)^{(n_1+n_2)/2}}, & y > 0 \\ 0, & y \le 0 \end{cases}

3. F分布的分位点 ​
  • 上侧 α\alpha 分位点定义: 对于一个概率 α\alpha (0<α<10 < \alpha < 1),如果存在一个正数 Fα(n1,n2)F_{\alpha}(n_1, n_2),使得随机变量 FF 大于或等于该值的概率恰好是 α\alpha,则称 Fα(n1,n2)F_{\alpha}(n_1, n_2) 为 F(n1,n2)F(n_1, n_2) 分布的上侧 α\alpha 分位点。

P{F≥Fα(n1,n2)}=αP\{F \ge F_{\alpha}(n_1, n_2)\} = \alpha

4. 分位点的性质 ​

提供了一个关于F分布分位点的重要性质和证明:

  • 性质: 下侧分位点与上侧分位点之间的关系。

F1−α(n1,n2)=1Fα(n2,n1)F_{1-\alpha}(n_1, n_2) = \frac{1}{F_{\alpha}(n_2, n_1)}

5.正态总体下的三大抽样定理 ​
定理一:标准化样本均值的分布(UU 统计量) ​

结论:当总体方差 σ2\sigma^2 已知时,标准化后的样本均值服从标准正态分布 N(0,1)N(0, 1)。

U=Xˉ−μσ/n∼N(0,1)U = \frac{\bar{X} - \mu}{\sigma/\sqrt{n}} \sim N(0, 1)

用途:用于总体均值 μ\mu 的大样本检验,或 σ2\sigma^2 已知时的单样本检验。


定理二:样本方差的分布(χ2\chi^2 统计量) ​

结论:将样本方差 S2S^2 乘以适当的系数后,服从自由度为 n−1n-1 的 χ2\chi^2 分布(卡方分布)。

χ2=(n−1)S2σ2∼χ2(n−1)\chi^2 = \frac{(n-1)S^2}{\sigma^2} \sim \chi^2(n-1)

用途:用于总体方差 σ2\sigma^2 的估计和检验。


定理三:tt 统计量的分布(小样本下的均值检验) ​

结论:当总体方差 σ2\sigma^2 未知时,使用样本标准差 SS 替代 σ\sigma 对 Xˉ\bar{X} 进行标准化,得到的统计量服从自由度为 n−1n-1 的 tt 分布。

T=Xˉ−μS/n∼t(n−1)T = \frac{\bar{X} - \mu}{S/\sqrt{n}} \sim t(n-1)

用途:用于总体均值 μ\mu 的小样本检验,或 σ2\sigma^2 未知时的单样本检验。


附加重要结论 ​
独立性结论 ​

在正态总体下,样本均值 Xˉ\bar{X} 与样本方差 S2S^2 相互独立。

(这是构建 TT 统计量的关键,因为 TT 统计量的构造要求分子 (UU) 和分母的平方根 (χ2/n\sqrt{\chi^2/n}) 相互独立)。

延伸:两个正态总体的方差比(FF 统计量) ​

FF 分布是这三大定理的自然延伸,它用于比较两个独立正态总体的方差。

设有两个独立样本,来自 N(μ1,σ12)N(\mu_1, \sigma_1^2) 和 N(μ2,σ22)N(\mu_2, \sigma_2^2):

F=S12/σ12S22/σ22∼F(n1−1,n2−1)F = \frac{S_1^2 / \sigma_1^2}{S_2^2 / \sigma_2^2} \sim F(n_1-1, n_2-1)

用途:用于检验两个总体的方差是否相等(即检验 H0:σ12=σ22H_0: \sigma_1^2 = \sigma_2^2)。

用 VitePress 搭建 · 托管在 GitHub Pages